语音离散化与自回归语言模型
端到端语音大模型的统一范式
一、引言
如果说传统语音系统是"识别、理解、合成"的分段流水线,那么语音大模型(Speech LLM) 的目标则是打破这些边界,让一个统一的模型直接处理语音、理解语音并生成语音,实现真正端到端的语音交互。
这一范式兴起的背后,是一个关键的技术转变:把连续语音信号离散化为"音频令牌"(Audio Tokens),从而让语音可以像文字一样,被自回归语言模型逐 token 地建模与生成。GPT-4o Realtime、Qwen2-Audio、VoiceChat 等前沿语音模型,几乎都遵循这一范式。它让语音处理得以"借用"大语言模型强大的序列建模与上下文学习能力,是当前对话式 AI 领域最激动人心的方向之一。
二、公式表达
端到端语音大模型的核心,是用自回归方式建模离散音频令牌序列的条件概率。给定输入语音 x_speech,模型生成输出音频/文本序列 Y 的概率为:
p(Y | X) = Π_t=1^T' p(y_t | y_<t, X), y_t ∈ 𝒱_audio, X = Encoder(x_speech)
各符号含义如下表所示。
符号 | 含义说明 |
|---|---|
x_speech | 输入语音波形(原始连续信号) |
Encoder(·) | 声学编码器,将波形映射为连续或离散的声学表示 |
X | 输入语音经编码后的表示(作为生成的条件) |
y_t | 第 t 个待生成令牌,属于音频词表 V_audio |
V_audio | 音频令牌的离散词表(由矢量量化得到) |
y_<t | 已生成的前缀令牌序列(自回归历史) |
p(y_t | y_<t, X) | 在给定输入与历史条件下,第 t 个令牌的条件概率 |
T' | 输出序列的总长度 |
p(Y | X) | 整个输出序列的联合概率 |
三、公式的推导与原理解析
(一)语音的离散化:从波形到音频令牌
连续语音无法直接用语言模型处理,因此第一步是"离散化"。常用的做法是采用神经音频编解码器(Neural Audio Codec,如 SoundStream、EnCodec),它利用矢量量化(Vector Quantization, VQ) 将连续的音频表示映射到有限个离散码本条目上。每个码本条目即一个"音频令牌",于是整段语音就变成了一个令牌序列,可以像文本一样被 token 化。
(二)自回归建模:逐 token 生成
上式是标准的自回归分解:把序列的联合概率按链式法则分解为每个 token 在给定前缀下的条件概率的连乘。模型(通常基于 Transformer)在每个位置 t,根据已经生成的 y_<t 和条件 X,预测下一个 token 的概率分布,然后采样或取 argmax 得到 y_t。这一机制与文本大语言模型完全一致,是"语音大模型"能与"文本大模型"共享训练范式与基础设施的根本原因。
(三)多模态融合与对齐
实际系统中,语音与文本往往共享同一套 Transformer 骨干,通过一个"语音-文本对齐"模块(如连接一个音频编码器的投影层)把声学表示映射到文本令牌空间。这样,模型既能理解语音(语音 → 文本),也能生成语音(文本 → 音频令牌 → 波形),实现双向的语音交互。
(四)情绪与韵律的可控注入
端到端语音大模型还天然支持在生成时注入额外的控制条件。例如,SynaVoice 知识库中提到的情绪韵律控制公式 e = W_e · (e + α · m_e · g),其本质就是在自回归生成的每一步,通过一个情绪向量 m_e 调节声学令牌的生成分布,从而让模型在"客户情绪激动时"自动切换为安抚性的语音风格。这体现了语音大模型在可控生成上的巨大潜力。
四、实际应用场景
(一)实时语音对话智能体
GPT-4o Realtime 等模型展示了端到端语音大模型在实时对话中的能力:直接输入语音、直接输出语音,省去"识别-理解-合成"的级联,延迟更低、情感更自然。这是 SynaVoice 等对话式语音智能体的未来演进方向。
(二)多模态理解与统一任务
Qwen2-Audio 等模型将语音与文本统一建模,支持语音问答、语音指令理解、音视频内容理解等多种任务,一个模型即可覆盖此前需要多个专用模型才能完成的工作。
(三)语音生成与音色克隆
基于离散令牌的自回归生成,配合声码器,可实现高质量语音合成、说话人音色克隆与风格迁移,广泛应用于配音、虚拟主播、个性化语音助手等场景。
五、示例说明
设用户对语音智能体说出一段语音"我有点生气,订单还没到"。系统流程如下:
编码:声学编码器将该语音编码为连续表示,再经矢量量化离散为一串音频令牌 X;
理解:自回归模型在 X 的条件下,逐 token 生成文本回复的令牌序列,如"非常抱歉给您带来困扰……",实现对用户情绪与意图的理解;
生成回复语音:模型继续在文本与情绪控制条件的引导下,生成回复语音的音频令牌序列 Y,再由声码器还原为波形;
情绪适配:若检测到用户情绪愤怒(情绪向量 m_e 增大),生成端会通过韵律控制公式调节输出,使回复语音更加温和、安抚。
整个过程由同一个自回归模型端到端完成,体现了语音大模型"理解与生成一体化"的优势。
六、小结
语音离散化 + 自回归语言模型,构成了端到端语音大模型的统一范式。它把语音纳入了大语言模型的"令牌世界",让语音交互得以共享文本大模型的强大能力。理解这一范式,就把握住了对话式 AI 从"分段流水线"迈向"统一大模型"的技术脉络。
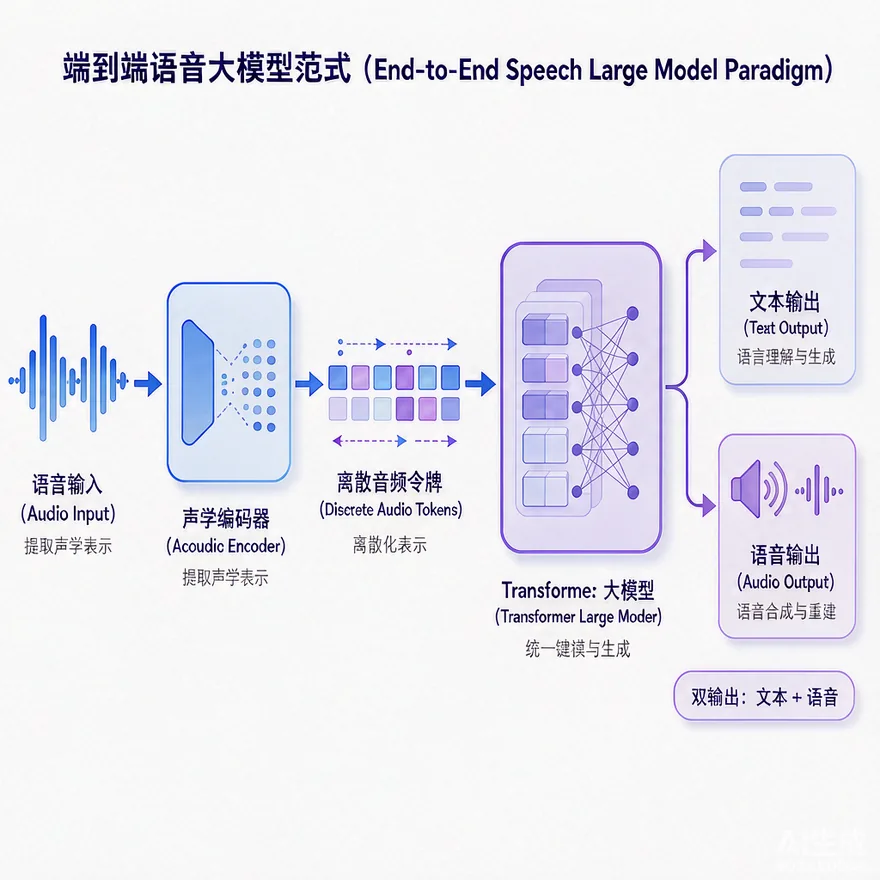
图 1 端到端语音大模型范式示意:离散音频令牌的自回归生成