注意力机制与声学特征对齐
神经语音合成的核心
一、引言
语音合成(Text-to-Speech, TTS)的任务,是把一段文字转换为自然、流畅的语音。在这条"文字 → 语音"的转化链路上,有一个绕不开的难题:对齐。一句话的每个字符(或音素)对应语音中的哪一段声学特征?字符与声学帧的长度往往相差悬殊,且这种对应关系随语速、语境而变化,无法用简单的规则预先确定。
注意力机制(Attention Mechanism)为解决这一难题提供了优雅的答案。它在 2014 年被引入机器翻译后,迅速成为序列建模的通用工具。在语音合成领域,以 Tacotron 2 为代表的神经 TTS 系统,正是借助注意力机制实现了"软对齐"——让解码器在生成每一帧声学特征时,动态地"关注"文本编码器中最相关的字符。
二、公式表达
注意力机制的核心是:为当前要生成的第 u 帧声学特征,计算它对文本第 t 个字符的"关注权重"。这一过程分为"打分"与"归一化"两步:
e_t,u = v^ᵀ tanh(W h_t + V h'_u + b), α_t,u = \fracexp(e_t,u)Σ_t' exp(e_t',u)
各符号含义如下表所示。
符号 | 含义说明 |
|---|---|
h_t | 编码器(文本侧)在第 t 个字符位置的隐状态 |
h'_u | 解码器在第 u 时刻的隐状态 |
W, V | 将编码器/解码器隐状态映射到注意力空间的权重矩阵 |
v, b | 注意力打分向量的权重与偏置 |
e_{t,u} | 第 t 个字符对第 u 帧的未归一化对齐打分(能量) |
α_{t,u} | 归一化后的注意力权重,表示"生成第 u 帧时应关注第 t 字符的程度" |
三、公式的推导与原理解析
(一)加性注意力的打分函数
上式采用的是一种"加性注意力"(Additive Attention,又称 Bahdanau Attention)。它先将编码器隐状态 h_t 与解码器隐状态 h'_u 分别经 W、V 线性映射后相加,再经 tanh 非线性激活,最后用向量 v 投影为一个标量打分 e_{t,u}。这个分数衡量了"字符 t 与当前生成位置 u 的相关程度"。
(二)Softmax 归一化得到注意力权重
对固定 u,将 e_{t,u} 对所有 t 做 softmax,得到一组和为 1 的权重 α_{t,u}。这些权重构成了一条"对齐分布"——在理想情况下,它应当是近似单调且尖锐的,即每个字符在对应的时间段内被重点关注。
(三)上下文向量与解码
解码器用注意力权重对编码器隐状态加权求和,得到"上下文向量" c_u = Σ_t α_{t,u} · h_t,再将其与解码器隐状态结合,预测第 u 帧的声学特征(如 Mel 谱)。如此逐帧生成,最终得到完整的声学序列,交由声码器合成波形。
(四)注意力对齐的常见问题与改进
注意力对齐在训练初期可能不稳定,出现"重复关注同一字符"或"跳过字符"等失败模式。为此,业界提出了多种改进:位置敏感注意力(Location-Sensitive Attention)、单调注意力(Monotonic Attention)、以及近年来更受欢迎的基于时长预测(Duration Predictor)的显式对齐方法(如 FastSpeech)。这些改进本质上都是为了让对齐更稳定、更可控。
四、实际应用场景
(一)神经语音合成
Tacotron 2 等序列到序列 TTS 系统以注意力机制实现文本到声学特征的对齐与生成,是端到端语音合成的里程碑。SynaVoice 知识库中提到的 GST(全局风格令牌)注意力,正是在此基础上扩展,将说话风格、韵律等可控变量注入合成过程。
(二)端到端语音识别
注意力机制同样是注意力编码器-解码器(AED)语音识别模型的核心,用于把声学帧对齐到输出字符,与 CTC 形成互补。
(三)多模态与跨模态对齐
注意力对齐的思想还广泛应用于语音到语音翻译、唇语识别、声纹与文本对齐等跨模态任务,是序列建模中通用的对齐工具。
五、示例说明
设要合成文本"你好",编码器输出三个隐状态 h₁(你)、h₂(好)以及一个结束符。解码器逐帧生成声学特征:
生成第 1 帧时,注意力权重 α_{t,1} 高度集中在 t=1("你"),表示这一帧主要对应"你"的发音;
随着帧推进,注意力重心平滑地右移到 t=2("好");
最终,注意力权重形成一条近似对角线、单调右移的"对齐路径"。
这张对齐图(通常以热力图形式可视化)直观地展示了模型如何把字符与声学帧一一对应,是调试与理解 TTS 系统的重要工具。
六、小结
注意力机制通过"打分 + softmax 归一化"的简洁设计,解决了语音合成中最棘手的对齐难题,让模型能够端到端地学习"文字 → 声学特征"的映射。它是神经 TTS 乃至整个序列建模领域的核心组件,理解注意力对齐,是深入语音合成与端到端识别的前提。
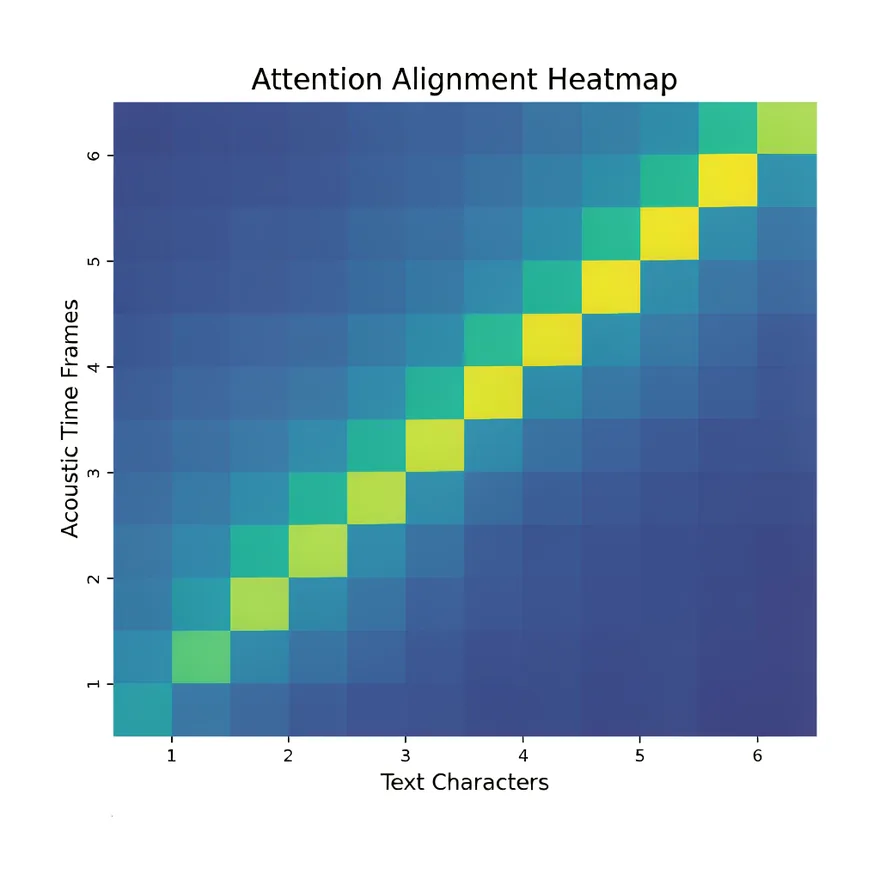
图 1 注意力对齐热力图示意:字符与声学帧沿对角线对齐