Mel 滤波器组特征
模拟人耳听觉的声学表示
一、引言
语音信号是一维的、随时间剧烈波动的声波,直接送入机器学习模型几乎不可行——既包含大量冗余,又难以突出与"听感"相关的信息。为此,语音识别、语音增强等系统几乎无一例外地先将原始波形转换为一种更具判别力的声学特征。其中,Mel 滤波器组(Mel Filterbank)特征及其进一步派生的梅尔频率倒谱系数(MFCC),是应用最广泛、影响最深远的特征表示之一。
Mel 特征的核心思想朴素而深刻:模拟人类听觉系统对频率的感知特性。人耳对不同频率的敏感度并非线性——我们对低频段的分辨能力远高于高频段。Mel 尺度正是对这一感知特性的数学近似。
二、公式表达
Mel 滤波器组特征的计算,本质是把功率谱通过一组在 Mel 尺度上等距分布的三角滤波器进行加权求和。第 f 个滤波器输出的能量为:
M_f = Σ_k=1^K |X_k|^2 · H_f(k)
其中三角滤波器的加权函数 H_f(k) 定义为:
H_f(k) = \begincases \dfrack - b_f-1b_f - b_f-1, & b_f-1 ≤ k ≤ b_f [6pt] \dfracb_f+1 - kb_f+1 - b_f, & b_f < k ≤ b_f+1 [6pt] 0, & 其他 \endcases
各符号含义如下表所示。
符号 | 含义说明 |
|---|---|
X_k | 第 k 个频点的短时傅里叶变换(STFT)系数 |
|X_k|² | 第 k 个频点的功率谱值 |
H_f(k) | 第 f 个三角 Mel 滤波器在第 k 个频点处的加权系数 |
b_f | 第 f 个滤波器在 Mel 尺度上的中心频率边界(对应到 FFT 频点索引) |
K | FFT 频点总数 |
M_f | 第 f 维 Mel 谱能量 |
三、公式的推导与原理解析
(一)从波形到频谱:短时傅里叶变换
语音是非平稳信号,但在一小段时间窗(通常 20–40 毫秒)内可近似视为平稳。因此,首先对分帧加窗后的每一帧做短时傅里叶变换(STFT),得到该帧的复频谱 X_k,再取其模平方得到功率谱 |X_k|²。功率谱反映了信号能量随频率的分布。
(二)Mel 尺度:频率的非线性压缩
人耳对音高的感知近似服从 Mel 尺度,它与线性频率 f(单位 Hz)的关系可近似表示为:
m = 2595 · log₁₀(1 + f/700)
在这一尺度上,等间隔分布的中心频率对应到线性频率域上是"低频密集、高频稀疏"的,恰好贴合人耳的听觉特性。
(三)三角滤波器的加权求和
在 Mel 尺度上等间隔取 F 个中心频率,为每个中心频率构造一个三角形滤波器(如公式 H_f(k) 所示,两端线性上升/下降,峰值处为 1)。每个滤波器的输出 M_f 是该三角形覆盖范围内各频点功率谱的加权和,相当于把密集的功率谱"压缩"成了 F 维(通常 40 或 80 维)的 Mel 谱。这一过程既降维,又突出了听觉敏感频段的信息。
(四)从 Mel 谱到 MFCC
在 Mel 谱基础上再取对数、做离散余弦变换(DCT),即可得到梅尔频率倒谱系数(MFCC)。倒谱变换的目的是去除滤波器组之间的相关性,得到更紧凑、去相关的特征。现代深度学习模型往往直接使用 Mel 谱(FBank)作为输入,而传统 GMM-HMM 系统则常用 MFCC。
四、实际应用场景
(一)语音识别的标准输入特征
Mel 谱 / MFCC 是绝大多数语音识别系统(传统混合系统与端到端模型)的标准输入。SynaVoice 的流式 ASR 引擎同样以 Mel 谱作为声学表示,它让模型专注于语音内容相关的声学信息,抑制噪声与说话人差异的干扰。
(二)语音合成与声码器的中间表示
在神经语音合成(TTS)中,Mel 谱是连接"文本编码器"与"神经声码器"的桥梁——声学模型先预测 Mel 谱,声码器再将 Mel 谱还原为波形。因此 Mel 特征横跨 ASR 与 TTS 两大领域。
(三)语音增强与说话人识别
Mel 谱也在语音增强(作为降噪模型输入/目标)、说话人识别、声音事件检测等任务中广泛使用,是一种通用而稳健的声学底层表示。
五、示例说明
设某帧语音的功率谱在 1000 Hz 附近能量较强,而在 5000 Hz 附近能量较弱。在 Mel 尺度下,1000 Hz 附近的滤波器分辨率更高、分布更密,能够精细刻画该频段的结构;而 5000 Hz 附近的滤波器则相对稀疏。经 Mel 滤波后,得到的 M_f 向量中,低频维度的取值能够更细腻地反映信号的共振峰与音色信息,这正是后续识别所依赖的关键线索。相比直接在原始线性频率上取特征,Mel 特征以更少的维度保留了更丰富的听觉信息。
六、小结
Mel 滤波器组特征以"模拟听觉"为出发点,通过 STFT、Mel 尺度映射与三角滤波三个步骤,把高维、冗余的波形压缩为紧凑、判别力强的声学表示。它是语音识别与合成共用的底层"语言",理解 Mel 特征的计算原理,是深入语音信号工程化的第一块基石。
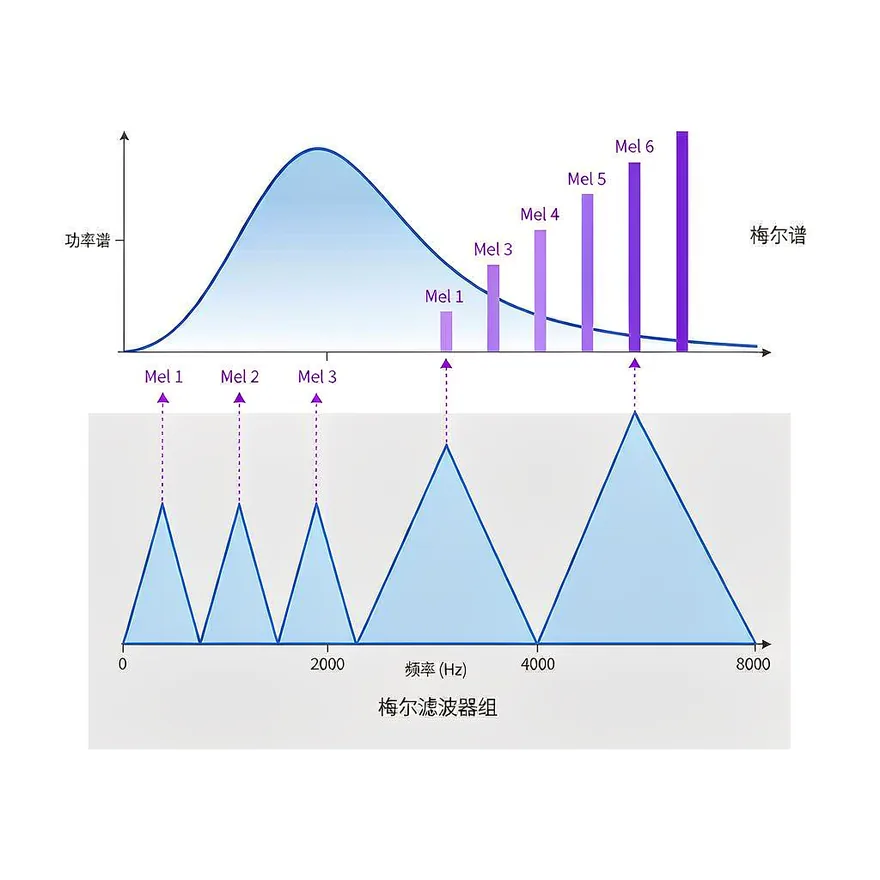
图 1 梅尔三角滤波器组示意:低频密集、高频稀疏的听觉映射